ai-plugin.json जेनरेटर
ऐसा JSON-LD चुनें, लागू करें, जाँचें और अद्यतन रखें जो सर्च और AI सिस्टम को आपके संगठन, सामग्री, उत्पादों और जवाबों की पहचान करने में मदद करे।
त्वरित जवाब
स्ट्रक्चर्ड डेटा से AI सर्च सिस्टम को पेज पर मौजूद इकाइयों, लेखकों, तारीखों, उत्पादों और दिखाई देने वाले जवाबों की पहचान करने में मदद मिलती है, लेकिन यह पेज का विकल्प नहीं है। लागू होने वाला सबसे विशिष्ट स्कीमा प्रकार चुनें, मार्कअप में शामिल हर दावे को पेज पर दिखाई देने वाला और सटीक रखें, स्थायी पहचानकर्ताओं से इकाइयों को जोड़ें और टेम्पलेट में हर बदलाव के बाद JSON-LD की जाँच करें।
इंटरैक्टिव जनरेटर खुद इंग्लिश में चलता है - इसे समझने और इस्तेमाल करने के लिए आपको जो कुछ भी चाहिए वह इस पेज पर समझाया गया है।
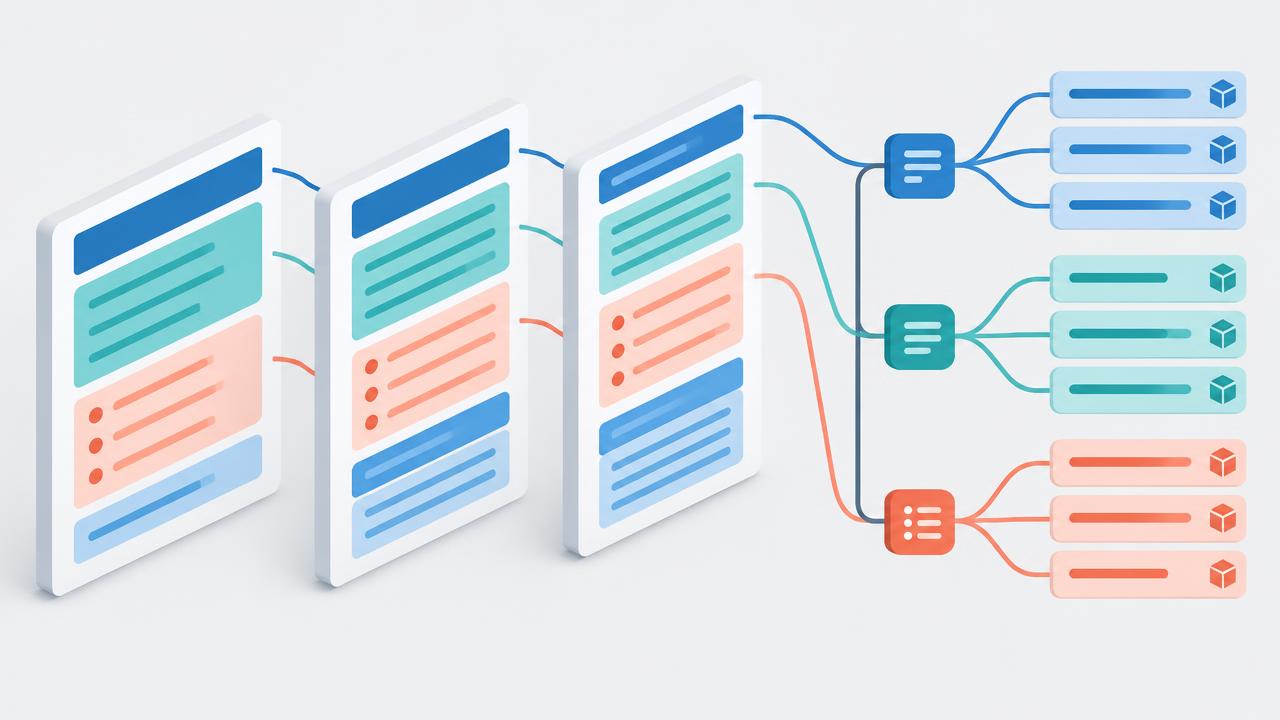
AI सर्च में स्ट्रक्चर्ड डेटा की क्या भूमिका है?
JSON-LD मशीनों को पेज का एक स्पष्ट ग्राफ़ देता है: इसे किसने प्रकाशित किया, यह किस इकाई का वर्णन करता है, इसमें कब बदलाव हुआ और इसके हिस्से आपस में कैसे जुड़े हैं। इससे जानकारी निकालते समय और उसका स्रोत तय करते समय अस्पष्टता कम होती है। यह किसी सर्च इंजन को पेज क्रॉल करने, उस पर भरोसा करने, उसे रैंक देने या स्रोत के रूप में उद्धृत करने के लिए बाध्य नहीं करता। इसलिए स्ट्रक्चर्ड डेटा पर काम करने से पहले क्रॉलर की पहुँच और पेज पर दिखाई देने वाली सामग्री सही होनी चाहिए।
आपको कौन-से स्कीमा प्रकार इस्तेमाल करने चाहिए?
| पेज का उद्देश्य | मुख्य प्रकार | ज़रूरी प्रॉपर्टी |
|---|---|---|
| कंपनी या ब्रांड | Organization | name, url, logo, sameAs |
| संपादकीय सामग्री | Article या BlogPosting | headline, author, datePublished, dateModified |
| नाम से पहचाना जाने वाला विशेषज्ञ | Person | name, jobTitle, affiliation, sameAs |
| उत्पाद या सॉफ़्टवेयर | Product या SoftwareApplication | name, brand, offers, और जहाँ प्रासंगिक हो वहाँ operatingSystem |
| पेज पर दिखाई देने वाले सवाल और जवाब | FAQPage | पेज से मेल खाते Question और acceptedAnswer |
| पेज पर दिखाई देने वाली क्रमबद्ध प्रक्रिया | HowTo | name और सही क्रम में सभी चरण |
एक सुसंगत एंटिटी ग्राफ़ कैसे बनाएँ?
- संगठन के लिए एक स्थायी @id चुनें और पूरी साइट पर उसी का इस्तेमाल करें।
- जहाँ उपयुक्त हो, publisher, provider, brand या affiliation में उसी संगठन का संदर्भ दें।
- Person इकाइयाँ केवल वास्तविक, नामित व्यक्तियों के लिए बनाएँ, जिनकी प्रोफ़ाइल और योग्यताएँ पेज पर दिखाई देती हों।
- sameAs में पहचान की पुष्टि करने वाले प्रामाणिक पेजों का इस्तेमाल करें, न कि हर उपलब्ध सोशल URL का।
- जब संबंध स्पष्ट हो और पेज पर दिखाई देता हो, तब हर पेज को उसके mainEntity या about विषयों से जोड़ें।
- नाम, URL, लोगो, तारीखें, कीमतें और उपलब्धता की जानकारी पेज के साथ अद्यतन रखें।
इसे सुरक्षित ढंग से लागू करने की प्रक्रिया क्या है?
JSON-LD उसी प्रामाणिक डेटा स्रोत से बनाएँ जिससे पेज पर दिखाई देने वाली सामग्री रेंडर होती है। इससे कीमत, उपलब्धता, तारीखों, FAQ के जवाबों और लेखक की जानकारी में अंतर नहीं आता। स्क्रिप्ट को सर्वर पर रेंडर करके अंतिम HTML में शामिल करें, सीरियलाइज़ की गई वैल्यू को सुरक्षित ढंग से एस्केप करें और प्लगइन व कस्टम कोड से कई परस्पर विरोधी इकाइयाँ जोड़ने से बचें।
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Structured data for AI search",
  "author": { "@id": "https://example.com/#organization" },
  "datePublished": "2026-09-22",
  "dateModified": "2026-09-22",
  "mainEntityOfPage": "https://example.com/guide"
}
स्ट्रक्चर्ड डेटा की जाँच कैसे करनी चाहिए?
| जाँच | सवाल | गड़बड़ी का उदाहरण |
|---|---|---|
| सिंटैक्स | क्या JSON वैध है? | अंतिम आइटम के बाद अतिरिक्त कॉमा या असुरक्षित सीरियलाइज़ेशन |
| शब्दावली | क्या प्रकार और प्रॉपर्टी schema.org की मान्य शब्दावली का हिस्सा हैं? | गलत प्रकार के साथ प्रॉपर्टी का इस्तेमाल |
| पात्रता | क्या लक्षित सर्च सुविधा इस मार्कअप को सपोर्ट करती है? | ऐसे रिच रिज़ल्ट की उम्मीद करना जो समर्थित नहीं है |
| तथ्यों की समानता | क्या हर महत्वपूर्ण दावा पेज पर दिखाई देने वाली सामग्री से मेल खाता है? | छिपा हुआ FAQ या अलग कीमत |
| डिलीवरी | क्या लाइव साइट के HTML में स्क्रिप्ट मौजूद है? | केवल क्लाइंट पर जोड़ी गई स्क्रिप्ट का क्रॉलर को न मिलना |
स्ट्रक्चर्ड डेटा की कौन-सी गलतियाँ सबसे ज़्यादा नुकसान करती हैं?
- ऐसे सवालों के लिए FAQPage जोड़ना जिनके जवाब पेज पर दिखाई नहीं देते।
- ऐसी समेकित रेटिंग या समीक्षाओं का इस्तेमाल करना जिन्हें विज़िटर देख और सत्यापित नहीं कर सकते।
- कीमत, उपलब्धता, लेखक या dateModified की पुरानी वैल्यू प्रकाशित करना।
- हर टेम्पलेट पर अलग-अलग नाम और URL वाली Organization इकाइयाँ बनाना।
- हर पेज को कई ऐसे मुख्य प्रकारों से चिह्नित करना जिनका आपस में संबंध नहीं है।
- यह मान लेना कि वैलिडेटर की जाँच पास होने से गुणवत्ता, पात्रता, इंडेक्सिंग या स्रोत के रूप में उद्धृत होने की पुष्टि हो जाती है।
AI में दृश्यता के लिए स्कीमा का असर कैसे मापें?
मापें कि मार्कअप ठीक करने के बाद इंजन इकाई को पहले से अधिक सटीक ढंग से पहचान और उसका वर्णन कर पा रहे हैं या नहीं। कितने मार्कअप की जाँच हुई, जानकारी निकालने में हुई गलतियाँ, जहाँ लागू हों वहाँ अतिरिक्त सर्च सुविधाएँ, क्रॉलर के विज़िट और तय प्रॉम्प्ट समूह के लिए स्रोत-संदर्भों की सटीकता ट्रैक करें। अगर उसी समय सामग्री, लिंक या क्रॉल करने की पहुँच भी बदली हो, तो दृश्यता में आए बदलाव का श्रेय केवल स्कीमा को न दें।
स्टेप बाय स्टेप
- 1पेज की मुख्य इकाई पहचानें
पेज पर स्पष्ट रूप से दिखाई देने वाले उद्देश्य से मेल खाने वाला सबसे विशिष्ट प्रकार चुनें।
- 2दिखाई देने वाले तथ्यों को प्रॉपर्टी से जोड़ें
उन प्रॉपर्टी की सूची बनाएँ जिनकी विज़िटर पुष्टि कर सकते हैं और अप्रमाणित या निजी दावों को छोड़ दें।
- 3स्थायी पहचानकर्ताओं से जोड़ें
संगठन और व्यक्ति के लिए वही @id वैल्यू दोबारा इस्तेमाल करें और sameAs संदर्भ सोच-समझकर चुनें।
- 4साझा डेटा से JSON-LD रेंडर करें
जानकारी में अंतर आने से रोकने के लिए मार्कअप उसी सामग्री स्रोत से बनाएँ जिससे पेज पर दिखाई देने वाली सामग्री बनती है।
- 5लाइव साइट पर जाँच करें
डिप्लॉयमेंट के बाद सिंटैक्स, शब्दावली, तथ्यों की समानता और सर्वर से रेंडर होकर आने वाले अंतिम रिस्पॉन्स की जाँच करें।
अक्सर पूछे जाने वाले प्रश्न
- क्या स्कीमा मार्कअप AI के जवाब में स्रोत के रूप में उद्धृत होने की गारंटी देता है?
- नहीं। स्ट्रक्चर्ड डेटा अस्पष्टता कम कर सकता है और सही स्रोत पहचानने में मदद कर सकता है, लेकिन स्रोत के रूप में उद्धृत होना क्रॉल करने की पहुँच, सामग्री की गुणवत्ता, प्रासंगिकता, प्रामाणिकता, ताज़गी और क्वेरी के लिए इस्तेमाल किए गए रिट्रीवल सिस्टम पर भी निर्भर करता है।
- क्या JSON-LD, माइक्रोडेटा से बेहतर है?
- पेज पर दिखाई देने वाले HTML में एट्रिब्यूट मिलाए बिना JSON-LD बनाना, अद्यतन रखना और जाँचना आम तौर पर आसान होता है। सबसे ज़रूरी बात यह है कि मार्कअप उस सामग्री का सटीक वर्णन करे जिसे विज़िटर देख सकते हैं।
- क्या FAQ स्कीमा में विज़िटर से छिपाए गए जवाब शामिल किए जा सकते हैं?
- ऐसा नहीं करना चाहिए। FAQPage मार्कअप में दिए गए सवाल और जवाब पेज पर दिखाई देने वाली सामग्री से मेल खाने चाहिए। छिपे हुए या विरोधाभासी जवाब तथ्यों में असंगति पैदा करते हैं और सर्च सुविधाओं के दिशानिर्देशों का उल्लंघन भी कर सकते हैं।
- क्या हर पेज पर Organization स्कीमा होना चाहिए?
- पूरी साइट पर एक स्थायी Organization इकाई का संदर्भ दिया जा सकता है, लेकिन उसकी परस्पर विरोधी पूरी परिभाषाएँ दोहराने से बचें। संगठन की परिभाषा एकसमान रखें और संबंधित पेजों से उसके स्थायी @id का संदर्भ दें।
- JSON-LD का ऑडिट कितनी बार करना चाहिए?
- टेम्पलेट, CMS, कीमत, लेखक, उत्पाद या नेविगेशन में बदलाव के बाद ऑडिट करें और नियमित रिलीज़ में स्ट्रक्चर्ड डेटा की जाँच शामिल करें। समय के साथ बदलने वाली प्रॉपर्टी उसी स्रोत से अपडेट होनी चाहिए जिससे पेज पर दिखाई देने वाली सामग्री अपडेट होती है।
संबंधित मुफ्त टूल
- llms.txt जनरेटरAI क्रॉलर के लिए मानक के अनुरूप llms.txt बनाएँ।
- llms.txt वैलिडेटरअपनी llms.txt की संरचना और लिंक की त्रुटियाँ जाँचें।
- AI के अनुकूल robots.txt जनरेटरGPTBot, ClaudeBot और PerplexityBot की पहुँच नियंत्रित करें।
- FAQ स्कीमा जनरेटरऐसा FAQPage JSON-LD बनाएँ जिसे AI उत्तरों में उद्धृत किया जा सके।
अपनी साइट की AI विज़िबिलिटी स्कैन करें
एक मुफ्त GEO और AEO स्कैन चलाएं और अपने डोमेन के लिए llms.txt, robots.txt, स्कीमा और कंटेंट फिक्स प्राप्त करें।
मुफ्त स्कैन चलाएं