LLM उद्धरण की जटिलता: रिट्रीवल, रैंकिंग बनाम रेंडरिंग को समझना और 2026 में AI ओवरव्यू के लिए ऑप्टिमाइज़ करना
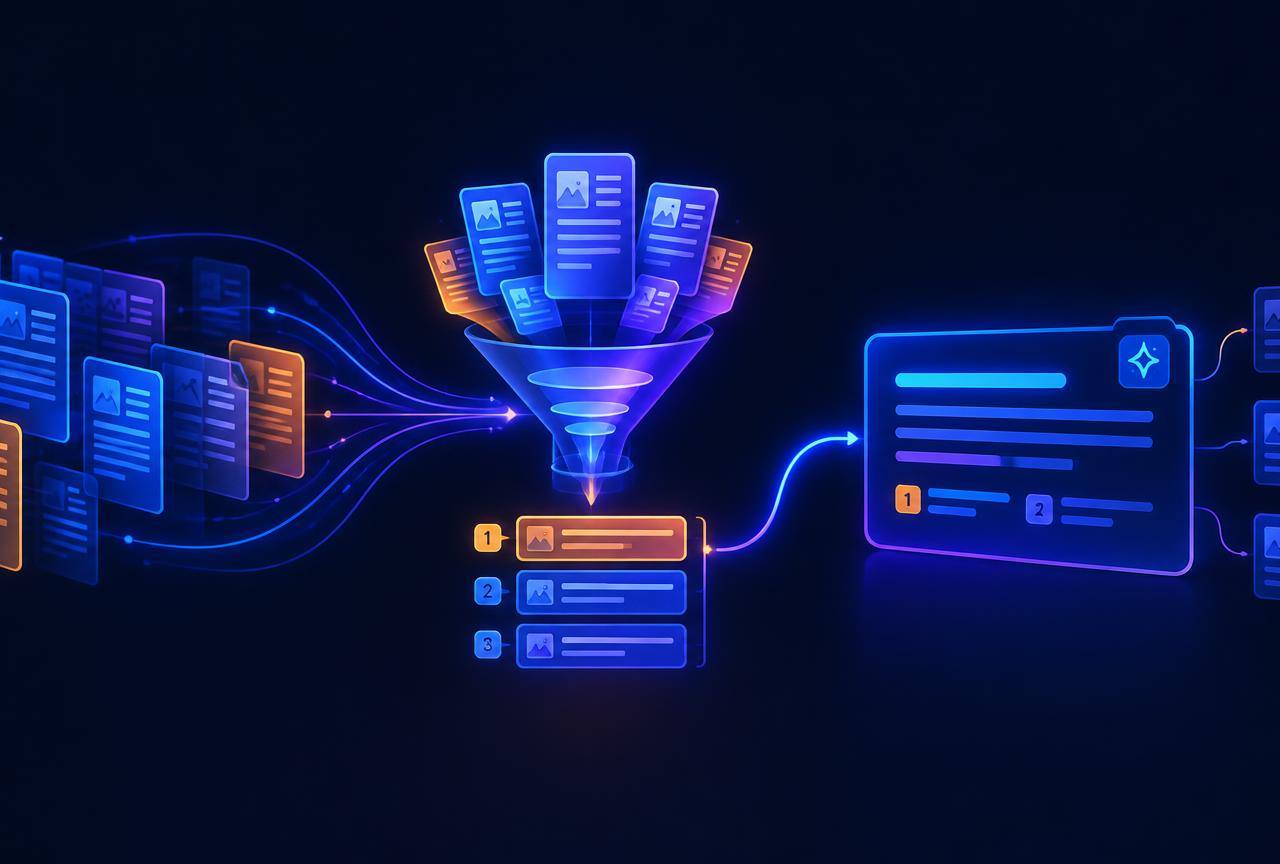
आज के डिजिटल परिदृश्य में, जहाँ लार्ज लैंग्वेज मॉडल्स (LLMs) और उनके अनुप्रयोग जैसे Google AI ओवरव्यू, Microsoft Copilot, और Perplexity AI जानकारी के प्राथमिक द्वार के रूप में तेजी से उभर रहे हैं, यह समझना महत्वपूर्ण है कि AI इन मॉडल्स में जानकारी को कैसे संसाधित, प्राथमिकता और प्रस्तुत करता है। विशेष रूप से, LLM उद्धरणों के तीन स्तंभ हैं: रिट्रीवल, रैंकिंग और रेंडरिंग। ये तीनों चरण मिलकर एक जटिल प्रक्रिया बनाते हैं जो यह निर्धारित करती है कि आपका कंटेंट AI जनित उत्तरों में, विशेष रूप से 'AI ओवरव्यू' और 'फीचर्ड स्निपेट्स' में कितनी अच्छी तरह दिखाई देगा। यह लेख इन तीनों अवधारणाओं की गहन तुलना प्रदान करता है, उनके कार्यों, महत्व और AI ओवरव्यू और अन्य जनरेटिव उत्तर इंजनों के लिए आपके कंटेंट को अनुकूलित करने के तरीकों पर प्रकाश डालता है। हम देखेंगे कि कैसे प्रत्येक चरण एक दूसरे से भिन्न है और फिर भी समग्र LLM अनुभव के लिए आवश्यक है, जिससे क्रिएटर्स, मार्केटर और SEO विशेषज्ञों को अपने डिजिटल पदचिह्न को प्रभावी ढंग से नेविगेट करने के लिए ज्ञान मिलता है, जो 2026 तक AI खोज के विकसित होते परिदृश्य के अनुकूल है।
LLM उद्धरण क्या है और 2026 में इसके मुख्य घटक क्या हैं?
LLM उद्धरण एक AI-जनित उत्तर में मूल जानकारी स्रोतों को संदर्भित करने की प्रक्रिया है, जिसमें रिट्रीवल, रैंकिंग और रेंडरिंग नामक तीन मुख्य घटक होते हैं, जो 2026 में AI की विश्वसनीयता, सटीकता और पारदर्शिता सुनिश्चित करते हैं।
LLM उद्धरण वह प्रक्रिया है जिसके द्वारा एक लार्ज लैंग्वेज मॉडल अपने जनित उत्तरों में मूल जानकारी स्रोतों को संदर्भित करता है। 2026 तक, यह LLM आउटपुट की विश्वसनीयता, सटीकता और पारदर्शिता को बढ़ाने के लिए एक महत्वपूर्ण तंत्र बन गया है, विशेष रूप से AI ओवरव्यू और चैटबॉट इंटरैक्शन में। जैसे मनुष्यों को अपने दावों का समर्थन करने के लिए अकादमिक पेपर या संदर्भों की आवश्यकता होती है, वैसे ही LLMs को भी अपने उत्तरों के स्रोत प्रदर्शित करने की आवश्यकता होती है ताकि उपयोगकर्ता उन पर भरोसा कर सकें और जानकारी की पुष्टि कर सकें। इसके बिना, LLM 'हैलुसिनेशन' (झूठी जानकारी उत्पन्न करना) की प्रवृत्ति रखते हैं, और उपयोगकर्ता यह नहीं जान पाते कि वे किस जानकारी पर भरोसा कर सकते हैं।
AI के परिपक्व होने के साथ, LLM उद्धरण में आम तौर पर तीन मुख्य, अलग-अलग लेकिन परस्पर जुड़े चरण होते हैं: रिट्रीवल, रैंकिंग और रेंडरिंग। ये चरण यह सुनिश्चित करते हैं कि LLM न केवल प्रासंगिक जानकारी ढूंढता है, बल्कि उसे सही ढंग से महत्व देता है और अंत में उसे उपयोगकर्ता के लिए एक उपयोगी और संदर्भित प्रारूप में प्रस्तुत करता है। इन चरणों को समझना SEO, AEO और GEO विशेषज्ञों के लिए आवश्यक है, क्योंकि यह सामग्री रचनाकारों को AI के लिए अपनी सामग्री को अधिक प्रभावी ढंग से अनुकूलित करने की अनुमति देता है। यह सिर्फ रैंकिंग के बारे में नहीं है; यह एक पारिस्थितिकी तंत्र में 'स्वीकृत' होने के बारे में है जहाँ AI तेजी से जानकारी के मध्यस्थ के रूप में कार्य कर रहा है और जहां 'सत्यता' (truthfulness) सर्वोच्च प्राथमिकता है।
- विश्वसनीयता बढ़ाना: स्रोतों को उद्धृत करके, LLMs अपने उत्तरों को मान्य करते हैं, जिससे उपयोगकर्ता का विश्वास बढ़ता है और 'हैलुसिनेशन' कम होता है।
- सटीकता में सुधार: यह AI द्वारा गलत या मनगढ़ंत जानकारी उत्पन्न करने की संभावना को नाटकीय रूप से कम करता है।
- पारदर्शिता प्रदान करना: उपयोगकर्ता को मूल जानकारी को सत्यापित करने या आगे तलाशने की अनुमति देता है, जिससे सूचित निर्णय लेने में मदद मिलती है।
- कॉपीराइट और नैतिकता का सम्मान: लेखकों और सामग्री क्रिएटर्स को क्रेडिट देकर बौद्धिक संपदा अधिकारों का सम्मान करता है।
- नवीनता और प्रासंगिकता: वास्तविक समय के डेटा को शामिल करके LLM उत्तरों को अद्यतित रखता है।
रिट्रीवल कैसे काम करता है और यह LLM उद्धरण में क्या भूमिका निभाता है?
रिट्रीवल LLM उद्धरण का प्रारंभिक और महत्वपूर्ण चरण है जहाँ एक सिस्टम प्रश्न के लिए प्रासंगिक, वास्तविक समय के टुकड़ों को एक विशाल ज्ञान भंडार से ढूंढता और निकालता है ताकि मॉडल के उत्तर निर्माण को सूचित किया जा सके और हैलुसिनेशन को कम किया जा सके।
रिट्रीवल प्रक्रिया LLM उद्धरण की नींव है, विशेष रूप से Retrieval Augmented Generation (RAG) वास्तुकला के माध्यम से। यह उस चरण को संदर्भित करता है जहाँ एक LLM या उससे जुड़ा एक सिस्टम एक दिए गए प्रश्न के लिए प्रासंगिक जानकारी के टुकड़ों को खोजने और निकालने का प्रयास करता है। यह एक विशाल, गतिशील ज्ञान भंडार से विशिष्ट तथ्यों, अवधारणाओं या खंडों की तलाश करने जैसा है। ये ज्ञान भंडार मॉडल के अपने प्रशिक्षण डेटा, बाहरी डेटाबेस, वेब पेजेस, रियल-टाइम न्यूज़ फ़ीड, या विशेष दस्तावेज़ों सहित विभिन्न रूपों में हो सकते हैं। 2026 तक, रिट्रीवल सिस्टम की क्षमताएं सिमेंटिक खोज, ज्ञान ग्राफ एकीकरण, मल्टीमॉडल रिट्रीवल और वास्तविक समय के डेटा स्ट्रीमिंग के साथ काफी विकसित हुई हैं।
पारंपरिक खोज इंजनों के विपरीत जो अक्सर वेब पेज से सीधे परिणाम लौटाते हैं, एक LLM रिट्रीवल सिस्टम उन डेटा पॉइंट्स को पुनर्प्राप्त करता है जो मॉडल के आंतरिक तर्क और जनरेशन प्रक्रिया को सूचित करेंगे। यह सिर्फ यूआरएल देने के बारे में नहीं है; यह 'कच्ची सामग्री' प्राप्त करने के बारे में है जिससे LLM संक्षेप में, विश्लेषण करेगा और फिर उत्तर बनाएगा। इस चरण में उपयोग किए जाने वाले एल्गोरिदम सिमेंटिक खोज, कीवर्ड मिलान, वेक्टर एम्बेडिंग और जटिलता मिलान पर आधारित होते हैं, ताकि यह सुनिश्चित किया जा सके कि पुनर्प्राप्त जानकारी न केवल प्रासंगिक हो बल्कि गहरी सामग्री से भी मेल खाती हो और 'सत्यता' के उच्च मानकों को पूरा करती हो। प्रभावी रिट्रीवल हैलुसिनेशन को रोकने और LLM को नवीनतम और सबसे सटीक जानकारी के साथ उत्तर देने में महत्वपूर्ण है।
रैंकिंग कैसे काम करता है और LLM उद्धरण में इसकी क्या भूमिका है?
रैंकिंग रिट्रीवल चरण द्वारा निकाले गए जानकारी के टुकड़ों को उनकी प्रासंगिकता, E-E-A-T, नवीनता और गुणवत्ता के आधार पर प्राथमिकता देती है ताकि LLM सबसे भरोसेमंद जानकारी का उपयोग करके अपना उत्तर दे सके और AI ओवरव्यू में प्रमुखता प्राप्त कर सके।
एक बार जब रिट्रीवल चरण कई संभावित प्रासंगिक जानकारी के टुकड़े निकाल लेता है, तो रैंकिंग चरण उसमें प्रवेश करता है। रैंकिंग का काम इन पुनर्प्राप्त दस्तावेजों या खंडों को उनकी प्रासंगिकता, अधिकार, नवीनता, गुणवत्ता और E-E-A-T के आधार पर प्राथमिकता देना है। यह सुनिश्चित करता है कि LLM सबसे उपयोगी और भरोसेमंद जानकारी का उपयोग करके अपने उत्तर का निर्माण करे, न कि केवल वही जो 'संबंधित' प्रतीत होता है। रैंकिंग एल्गोरिदम अब अत्यधिक जटिल हैं और इसमें विभिन्न कारक शामिल हो सकते हैं, जैसे स्रोत का अपडेटेड 'अथॉरिटी स्कोर' (PageRank का एक विकसित रूप), लेखक की विशेषज्ञता, प्रकाशन की प्रतिष्ठा, जानकारी कितनी ताज़ा है, और यहां तक कि उपयोगकर्ता का व्यक्तिगत संदर्भ या इतिहास भी शामिल है। 2026 में Google के गुणवत्ता मूल्यांकन दिशानिर्देशों में E-E-A-T पर और भी अधिक जोर दिया गया है, खासकर 'अनुभव' आयाम पर, जो इस चरण की महत्वपूर्णता को रेखांकित करता है।
LLM के संदर्भ में, रैंकिंग केवल 'सर्वश्रेष्ठ' वेब पेज खोजने के बारे में नहीं है, बल्कि उन विशिष्ट स्निपेट्स या डेटा पॉइंट्स की पहचान करने के बारे में है जो दिए गए प्रश्न के लिए सबसे सटीक, संक्षिप्त और आधिकारिक उत्तर में योगदान करेंगे। उच्च गुणवत्ता वाले स्रोतों को प्राथमिकता देने से न केवल निर्मित उत्तर की गुणवत्ता में सुधार होता है बल्कि यह भी सुनिश्चित होता है कि LLM जिन उद्धरणों को इंगित करता है वे वास्तव में विश्वसनीय और तथ्यात्मक रूप से सही हैं। रैंकिंग मॉडल अक्सर उन्नत मशीन लर्निंग मॉडल (जैसे ट्रांसफॉर्मर-आधारित मॉडल) का उपयोग करते हैं, जो प्रासंगिक दस्तावेजों की पहचान करने के लिए बड़े डेटासेट पर प्रशिक्षित होते हैं, जिससे वे लगातार अपनी सटीकता और दक्षता में सुधार कर पाते हैं, यहां तक कि सूक्ष्म संदर्भों को भी समझ पाते हैं।
- स्रोत का E-E-A-T (विशेषज्ञता, अनुभव, अधिकार, विश्वसनीयता), जिसे 2026 में 'अनुभव' घटक पर अधिक बल दिया गया है।
- सामग्री की तथ्यात्मक सटीकता और सत्यापन योग्य सत्यता।
- जानकारी की ताज़गी और नवीनता, विशेष रूप से तेजी से बदलते विषयों के लिए महत्वपूर्ण।
- अन्य विश्वसनीय, उच्च-अधिकार वाले स्रोतों से प्राप्त लिंक या उद्धरण।
- उपयोगकर्ता एंगेजमेंट मेट्रिक्स और संतुष्टि (यदि AI ओवरव्यू द्वारा ट्रैक किए गए हों)।
- कंटेंट का निष्पक्षता, पूर्वाग्रह की कमी और स्पष्ट मेथोडोलॉजी।
- मल्टीमॉडल प्रासंगिकता: क्या छवि, वीडियो या ऑडियो सामग्री भी प्रश्न के लिए प्रासंगिक और विश्वसनीय है।
रेंडरिंग कैसे काम करता है और LLM उद्धरण में इसकी क्या भूमिका है?
रेंडरिंग LLM उद्धरण का अंतिम चरण है जहाँ LLM द्वारा निर्मित उत्तर और उसके उद्धरण उपयोगकर्ता को एक स्पष्ट, संक्षिप्त, संरचित और मल्टीमॉडल प्रारूप में प्रस्तुत किए जाते हैं, जिससे पारदर्शिता, विश्वास और उपयोगकर्ता अनुभव बढ़ता है।
रेंडरिंग LLM उद्धरण का अंतिम चरण है, जहाँ LLM द्वारा निर्मित अंतिम उत्तर, जिसमें प्रासंगिक उद्धरण शामिल हैं, उपयोगकर्ता को प्रस्तुत किया जाता है। 2026 तक, रेंडरिंग सिर्फ टेक्स्ट उत्पन्न करने से कहीं अधिक है; यह जानकारी को एक स्पष्ट, संक्षिप्त, समझने योग्य और संरचित प्रारूप में प्रस्तुत करने के बारे में है, जिसमें मूल स्रोतों के स्पष्ट और इंटरैक्टिव संकेत हों। एक प्रभावी रेंडरिंग यह सुनिश्चित करता है कि उपयोगकर्ता न केवल LLM द्वारा प्रदान किए गए उत्तर को समझें, बल्कि यह भी जानें कि जानकारी कहाँ से आई है और यदि वे चाहें तो आगे की खोज कर सकें। यह AI ओवरव्यू, चैटबॉट कन्वर्सेशन और अन्य AI-जनित सारांशों में उपयोगकर्ता विश्वास और संतुष्टि के लिए महत्वपूर्ण है।
रेंडरिंग में केवल यूआरएल शामिल करना ही नहीं होता। इसमें यह भी शामिल हो सकता है कि LLM जानकारी को कैसे सारगर्भित करता है, उसे कैसे संरचित करता है (जैसे बुलेट पॉइंट, नंबर वाली सूचियाँ, तालिकाएँ), और उद्धरणों को दृश्यमान रूप से कैसे एकीकृत करता है (उदाहरण के लिए, इनलाइन लिंक, फुटनोट, संदर्भ अनुभाग, या यहां तक कि स्रोत पर होवर करने पर अतिरिक्त जानकारी)। लक्ष्य एक सहज अनुभव प्रदान करना है जहाँ AI-जनित सामग्री सूचनात्मक हो और उसके स्रोतों के साथ आसानी से जोड़ा जा सके। यह उपयोगकर्ता को AI के 'सोच' प्रक्रिया की एक झलक भी प्रदान कर सकता है। 2026 में, मल्टीमॉडल रेंडरिंग भी महत्वपूर्ण हो गई है, जहाँ AI टेक्स्ट के साथ-साथ प्रासंगिक छवियों, वीडियो या इंटरेक्टिव तत्वों को भी प्रस्तुत कर सकता है, जो मल्टीमॉडल LLM से प्राप्त जानकारी पर आधारित होते हैं।
"ज्ञान तक पहुँच एक बात है; इसे संक्षिप्त रूप में, विश्वास के साथ और सटीक रूप से प्रदान करना संपूर्ण कला है। 2026 में LLM रेंडरिंग उस कला का सबसे परिष्कृत अनावरण है, जो पारदर्शिता और उपयोगकर्ता केंद्रितता पर केंद्रित है।"
रिट्रीवल बनाम रैंकिंग बनाम रेंडरिंग: 2026 में एक गहन तुलना
रिट्रीवल 'प्रासंगिक जानकारी ढूंढने' पर केंद्रित है, रैंकिंग 'उस जानकारी को E-E-A-T और नवीनता के आधार पर प्राथमिकता देने' पर केंद्रित है, और रेंडरिंग 'अंतिम, संदर्भित, उपयोगकर्ता-अनुकूल उत्तर प्रस्तुत करने' पर केंद्रित है, जिसमें प्रत्येक चरण LLM उद्धरण के समग्र प्रवाह में एक अद्वितीय लेकिन आवश्यक…
LLM उद्धरण के तीनों स्तंभों को व्यक्तिगत रूप से समझने के बाद, उनकी सीधी तुलना करना यह समझने के लिए महत्वपूर्ण है कि वे कैसे भिन्न हैं और एक साथ कैसे काम करते हैं। हालाँकि वे सभी एक समान लक्ष्य साझा करते हैं - सटीक, विश्वसनीय और उपयोगकर्ता-केंद्रित AI-जनित उत्तरों की सुविधा प्रदान करना - वे अपनी कार्यप्रणाली, उद्देश्य और LLM के साथ अपनी बातचीत के बिंदु में स्पष्ट रूप से भिन्न होते हैं। 2026 तक, ये अंतर और भी स्पष्ट हो गए हैं क्योंकि प्रत्येक चरण अधिक परिष्कृत तकनीकों और AI खोज के उच्च मानकों से प्रभावित है।
रिट्रीवल प्रक्रिया मुख्य रूप से 'खोज' कार्य के बारे में है: स्रोतों के एक बड़े, गतिशील पूल से संभावित रूप से प्रासंगिक और वास्तविक समय के डेटा को बाहर निकालना। यह एक विशाल पुस्तकालय में सही और नवीनतम किताबें ढूंढने जैसा है। रैंकिंग, इसके विपरीत, 'मूल्यांकन' और 'प्राथमिकीकरण' का कार्य है: उन किताबों में से, जो प्रश्न के लिए सबसे आधिकारिक, प्रासंगिक, नवीनतम, पूर्वाग्रह-मुक्त और E-E-A-T मानदंडों को पूरा करती हैं, उन्हें निर्धारित करना। यह उन किताबों को छांटने और उन्हें उनकी उपयोगिता और सत्यता के आधार पर क्रमबद्ध करने जैसा है। अंत में, रेंडरिंग 'प्रस्तुति' का कार्य है: अंतिम उत्तर तैयार करना, जिसमें उस सबसे अच्छी किताब से निकाली गई सामग्री को शामिल किया जाए, और यह सुनिश्चित किया जाए कि यह स्पष्ट रूप से उद्धृत, समझने योग्य और इंटरैक्टिव हो। इस चरण में लेआउट, स्पष्टीकरण और उपयोगकर्ता अनुभव पर ध्यान केंद्रित किया जाता है, जो AI ओवरव्यू के लिए महत्वपूर्ण है।
| विशेषता | रिट्रीवल | रैंकिंग | रेंडरिंग |
|---|---|---|---|
| मुख्य कार्य | प्रासंगिक और वास्तविक समय की जानकारी ढूंढना और निकालना | पुनर्प्राप्त जानकारी को E-E-A-T, नवीनता और सटीकता के आधार पर प्राथमिकता देना | अंतिम, संदर्भित, उपयोगकर्ता-अनुकूल उत्तर प्रस्तुत करना |
| मुख्य उद्देश्य | विशिष्ट, तथ्यात्मक डेटा बिंदुओं की पहचान | विश्वसनीयता, प्रासंगिकता और सत्यता का आकलन | स्पष्टता, पारदर्शिता, पठनीयता और उपयोगकर्ता संतुष्टि सुनिश्चित करना |
| यह क्या प्रतिक्रिया देता है? | कंटेंट के संभावित खंड या दस्तावेज़ (वास्तविक समय के डेटा सहित) | प्राथमिकता प्राप्त, सत्यापित स्रोत या स्निपेट्स | LLM-जनित उत्तर + उनके इंटरैक्टिव उद्धरण |
| उपयोग की जाने वाली तकनीकें | सिमेंटिक खोज, वेक्टर एम्बेडिंग, ज्ञान ग्राफ, वास्तविक समय डेटा फ़ीड्स, मल्टीमॉडल रिट्रीवल | मशीन लर्निंग मॉडल (ट्रांसफॉर्मर), E-E-A-T मेट्रिक्स, अथॉरिटी एल्गोरिदम, पूर्वाग्रह डिटेक्शन | टेक्स्ट जनरेशन, संरचित आउटपुट (JSON), सारांश, इंटरैक्टिव लिंक एम्बेडिंग, मल्टीमॉडल प्रस्तुति |
| AEO/GEO प्रभाव | कंटेंट की AI खोज योग्यता और RAG द्वारा पहचान | AI ओवरव्यू में कंटेंट की दृश्यता और विश्वसनीयता की संभावना | AI ओवरव्यू/उत्तरों में कंटेंट का 'फीचर्ड' होना और उपयोगकर्ता एंगेजमेंट |
| कंटेंट ऑप्टिमाइजेशन | स्पष्ट कीवर्ड, संरचित डेटा, सिमेंटिक टैग, वास्तविक समय डेटा अपडेट | उच्च E-E-A-T, नवीनता, गुणवत्ता, विश्वसनीय बैकलिंक, पूर्वाग्रह-मुक्त लेखन, फर्स्ट-हैंड अनुभव | संक्षिप्तता, स्पष्ट सारांश, स्कीमा, प्रत्यक्ष उत्तर, इंटरैक्टिव तत्व, मल्टीमॉडल अनुकूलता |
ज्ञान ग्राफ और सिमेंटिक खोज का बढ़ता प्रभाव
2026 में ज्ञान ग्राफ और सिमेंटिक खोज LLM उद्धरण के रिट्रीवल और रैंकिंग चरणों पर महत्वपूर्ण प्रभाव डाल रहे हैं, जिससे AI को अवधारणाओं और संस्थाओं के बीच संबंधों को बेहतर ढंग से समझने में मदद मिलती है, जिसके लिए संरचित सामग्री अनुकूलन की आवश्यकता होती है।
2026 में, रिट्रीवल और रैंकिंग दोनों प्रक्रियाओं में ज्ञान ग्राफ और उन्नत सिमेंटिक खोज का प्रभाव काफी बढ़ गया है। पारंपरिक कीवर्ड मिलान से आगे बढ़ते हुए, AI सिस्टम अब अवधारणाओं, संस्थाओं और उनके बीच के संबंधों को बेहतर ढंग से समझते हैं। ज्ञान ग्राफ AI को न केवल यह पहचानने में मदद करते हैं कि एक विशेष शब्द क्या है, बल्कि यह भी कि यह अन्य संस्थाओं से कैसे संबंधित है, जिससे अधिक सटीक और प्रासंगिक जानकारी पुनर्प्राप्त होती है।
उदाहरण के लिए, यदि कोई उपयोगकर्ता 'मंगल ग्रह पर पानी' के बारे में पूछता है, तो एक उन्नत सिमेंटिक रिट्रीवल सिस्टम केवल 'मंगल' और 'पानी' वाले पृष्ठों को नहीं ढूंढेगा, बल्कि 'मंगल ग्रह पर तरल जल', 'जीवन की संभावना' और 'नासा के मिशन' जैसी संबंधित अवधारणाओं को भी समझेगा। रैंकिंग एल्गोरिदम अब ज्ञान ग्राफ में एक स्रोत की स्थिति और उसकी संबद्ध संस्थाओं की विश्वसनीयता का भी मूल्यांकन कर सकते हैं। यह सामग्री क्रिएटर्स के लिए महत्वपूर्ण है, क्योंकि इसका मतलब है कि आपको केवल कीवर्ड स्टफिंग पर ध्यान केंद्रित नहीं करना चाहिए, बल्कि अपनी सामग्री में अवधारणाओं और संस्थाओं के बीच स्पष्ट और तार्किक संबंध बनाने चाहिए, और अपनी सामग्री को संरचित डेटा के माध्यम से ज्ञान ग्राफ के अनुकूल बनाना चाहिए।
AI ओवरव्यू और चैटबॉट इंटरफेस में रेंडरिंग की चुनौती
AI ओवरव्यू और चैटबॉट इंटरफेस के उदय ने रेंडरिंग को और अधिक चुनौतीपूर्ण बना दिया है, जिसके लिए संवादात्मक, संक्षिप्त और दृश्यमान रूप से आकर्षक प्रारूपों में जानकारी प्रस्तुत करने के लिए सामग्री को 'चैटबॉट-तैयार' और संरचित करने की आवश्यकता है।
AI ओवरव्यू और उन्नत चैटबॉट इंटरफेस के व्यापक होने के साथ, रेंडरिंग चरण ने नए आयाम प्राप्त किए हैं। अब यह केवल टेक्स्ट आउटपुट करने के बारे में नहीं है, बल्कि जानकारी को एक ऐसे प्रारूप में प्रस्तुत करने के बारे में है जो संवादात्मक, संक्षिप्त और दृश्यमान रूप से आकर्षक हो। AI ओवरव्यू अक्सर विभिन्न स्रोतों से जानकारी को संश्लेषित करते हैं, और उन्हें एक सुसंगत, पढ़ने में आसान सारांश में प्रस्तुत करना एक चुनौती है।
चैटबॉट इंटरफेस में, रेंडरिंग उपयोगकर्ता की बातचीत के प्रवाह के अनुरूप होनी चाहिए। इसका मतलब है कि केवल एक लंबा पैराग्राफ प्रदान करने के बजाय, AI को जानकारी को छोटे, प्रबंधनीय चंक्स में तोड़ना पड़ सकता है, या यहां तक कि follow-up प्रश्नों के लिए प्रॉम्प्ट भी देना पड़ सकता है। सामग्री क्रिएटर्स के लिए, इसका अर्थ है कि आपकी सामग्री को न केवल सीधे उत्तर प्रदान करने चाहिए, बल्कि उन्हें संरचित और 'चैटबॉट-तैयार' तरीके से भी प्रस्तुत किया जाना चाहिए, जैसे कि छोटे पैराग्राफ, स्पष्ट FAQ और बुलेट पॉइंट का उपयोग करना। दृश्य तत्व, जैसे चार्ट और इन्फोग्राफिक्स, भी रेंडरिंग में एक बड़ी भूमिका निभा सकते हैं, क्योंकि AI अब मल्टीमॉडल आउटपुट देने में सक्षम है।
मल्टीमॉडल रिट्रीवल और रेंडरिंग: 2026 में नई सीमाएँ
2026 में मल्टीमॉडल LLM के साथ, रिट्रीवल और रेंडरिंग अब टेक्स्ट के अलावा छवियों, वीडियो और ऑडियो जैसे विभिन्न मीडिया प्रकारों को भी शामिल करते हैं, जिसके लिए मल्टीमीडिया सामग्री के अनुकूलन की आवश्यकता होती है।
जैसे-जैसे LLM अधिक मल्टीमॉडल होते जा रहे हैं, जानकारी को केवल टेक्स्ट तक सीमित रखना पर्याप्त नहीं है। 2026 तक, AI मॉडल न केवल टेक्स्ट-आधारित जानकारी को पुनर्प्राप्त और रैंक कर रहे हैं, बल्कि प्रासंगिक छवियों, वीडियो, ऑडियो क्लिप और इंटरैक्टिव सिमुलेशन को भी शामिल कर रहे हैं। इसका मतलब है कि रिट्रीवल सिस्टम अब विभिन्न मीडिया प्रकारों से जानकारी को समझ और निकाल सकते हैं। उदाहरण के लिए, एक प्रश्न के उत्तर में, एक AI ओवरव्यू किसी विशेष अवधारणा को समझाने के लिए एक प्रासंगिक इन्फोग्राफिक या एक छोटा शैक्षिक वीडियो उद्धृत कर सकता है।
सामग्री क्रिएटर्स के लिए, इसका निहितार्थ यह है कि आपके मल्टीमीडिया कंटेंट को भी AI के लिए अनुकूलित किया जाना चाहिए। उच्च-गुणवत्ता वाले, प्रासंगिक इमेज, वीडियो और ऑडियो का उपयोग करें, उन्हें उचित Alt टैग, कैप्शन, ट्रांसक्रिप्ट और संरचित डेटा के साथ टैग करें। AI न केवल यह मूल्यांकन कर रहा है कि आपका टेक्स्ट कितना विश्वसनीय है, बल्कि यह भी कि आपकी दृश्य और श्रव्य सामग्री कितनी उपयोगी, अधिकारपूर्ण और प्रासंगिक है। मल्टीमॉडल रेंडरिंग अब उपयोगकर्ताओं को एक अधिक समृद्ध और व्यापक उत्तर प्रदान करने की अनुमति देती है, जिससे AI-जनित उत्तरों का उपयोगकर्ता अनुभव काफी बढ़ जाता है।
AI नैतिकता, जवाबदेही और उद्धरण का भविष्य
2026 में AI नैतिकता और जवाबदेही के महत्व के साथ, LLM उद्धरण का भविष्य पारदर्शिता, सत्यापन योग्य स्रोतों और सामग्री की नैतिक अखंडता के इर्द-गिर्द घूमता है, जो विश्वसनीय AI प्रतिक्रियाओं के लिए महत्वपूर्ण है।
LLM उद्धरण का भविष्य सिर्फ तकनीकी उन्नयन से परे है; यह AI नैतिकता, जवाबदेही और सामाजिक प्रभाव के साथ भी गहराई से जुड़ा हुआ है। 2026 तक, नियामक निकाय और प्रौद्योगिकी कंपनियाँ दोनों AI पारदर्शिता और सत्यापन योग्य स्रोतों पर बहुत अधिक ध्यान केंद्रित कर रही हैं। AI को जिम्मेदार बनाने और हानिकारक पूर्वाग्रहों या गलत सूचनाओं के प्रसार को रोकने के लिए स्पष्ट उद्धरण तंत्र आवश्यक हैं।
जैसे-जैसे AI समाज के अधिक पहलुओं में एकीकृत होता है, यह जानना महत्वपूर्ण होगा कि AI द्वारा प्रदान की गई जानकारी कहाँ से आती है, किसने इसे बनाया है, और क्या इसे सत्यापित किया गया है। यह 'प्रोवेंस' (Provenance) का मुद्दा LLM उद्धरण के विकास में एक महत्वपूर्ण भूमिका निभाएगा। NVIDIA NeMo Guardrails जैसे उपकरण और Google के E-E-A-T दिशानिर्देशों का निरंतर विकास इस बात को रेखांकित करता है कि 'सत्यता', 'सुरक्षा' और 'विश्वसनीयता' अब LLM प्रदर्शन के केंद्र में हैं। सामग्री क्रिएटर्स के लिए, इसका मतलब है कि केवल अनुकूलन पर्याप्त नहीं है; आपको अपनी सामग्री की नैतिक अखंडता, सटीकता और सामाजिक जिम्मेदारी के प्रति प्रतिबद्धता भी प्रदर्शित करनी होगी ताकि AI सिस्टम द्वारा उच्च विश्वसनीयता के साथ उद्धृत किया जा सके।
आपके कंटेंट के लिए AEO और GEO को बेहतर बनाने हेतु रणनीतियाँ (2026)
LLM उद्धरण के लिए AEO और GEO को बेहतर बनाने हेतु, कंटेंट को रिट्रीवल (सिमेंटिक प्रासंगिकता, वास्तविक समय), रैंकिंग (उच्च E-E-A-T, विश्वसनीयता), और रेंडरिंग (संक्षिप्तता, स्पष्ट संरचना, स्कीमा, मल्टीमॉडल) के लिए ऑप्टिमाइज़ करें, विशेष रूप से AI ओवरव्यू में।
AI संचालित सर्च और जनरेटिव मॉडल के इस नए युग में, आपके कंटेंट को सिर्फ पारंपरिक SEO के लिए ऑप्टिमाइज़ करना पर्याप्त नहीं है। आपको अपनी सामग्री को इस तरह से तैयार करने की आवश्यकता है जिससे वह रिट्रीवल, रैंकिंग और रेंडरिंग तीनों चरणों में उत्कृष्टता प्राप्त कर सके। यह विशेष रूप से Google AI ओवरव्यू और अन्य जनरेटिव AI प्लेटफॉर्म पर दृश्यता प्राप्त करने के लिए महत्वपूर्ण है। यहाँ कुछ अद्यतित रणनीतियाँ दी गई हैं:
आपकी सामग्री की खोज योग्यता सुनिश्चित करने के लिए, आपको न केवल सही कीवर्ड का उपयोग करना होगा, बल्कि सिमेंटिक रूप से संबंधित विषयों और अवधारणाओं को भी कवर करना होगा। एक अच्छी तरह से संरचित सामग्री जो उपयोगकर्ता के सवालों का सीधे जवाब देती है, उसे उन्नत रिट्रीवल सिस्टम द्वारा आसानी से पहचाना जाएगा। रैंकिंग के लिए, विश्वसनीयता सर्वोपरि है। इसका मतलब है कि विशेषज्ञता, अनुभव, अधिकार और विश्वसनीयता (E-E-A-T) के सिद्धांतों का उच्चतम स्तर पर पालन करना। अपने दावा किए गए तथ्यों का समर्थन करने के लिए उच्च-गुणवत्ता वाले, अकादमिक, आधिकारिक या वास्तविक समय के डेटा स्रोतों से लिंक करें। अंत में, रेंडरिंग के लिए, अपनी सामग्री को इस तरह से डिज़ाइन करें जिससे AI इसे आसानी से पचा सके और सारगर्भित कर सके। स्पष्ट शीर्षक, बुलेट पॉइंट और संक्षिप्त सारांश AI ओवरव्यू के लिए महत्वपूर्ण हैं, साथ ही मल्टीमीडिया कंटेंट का उचित अनुकूलन भी।
- 1स्पष्ट और संक्षिप्त शीर्षक एवं उपशीर्षक
अपने लेखों के लिए ऐसे शीर्षक बनाएं जो सीधे उपयोगकर्ता के प्रश्नों का उत्तर दें और मुख्य विषय को स्पष्ट करें। H1, H2 टैग का सही उपयोग करें।
- 2उन्नत संरचित डेटा लागू करें
Google और अन्य AI को आपकी सामग्री को समझने में मदद करने के लिए उन्नत स्कीमा मार्कअप (जैसे FAQPage, HowTo, Article, Review, QAPage, ImageObject, VideoObject) का उपयोग करें।
- 3सीधे और अद्यतित उत्तर प्रदान करें
अपने कंटेंट में प्रश्नों के प्रत्यक्ष, संक्षिप्त, तथ्यात्मक और अद्यतित उत्तरों को प्रमुखता से शामिल करें, अधिमानतः परिचय या सारांश में।
- 4उच्च विश्वसनीयता और अधिकार स्थापित करें
अपनी E-E-A-T (विशेषज्ञता, अनुभव, अधिकार और विश्वसनीयता) को मजबूत करें। अपने क्षेत्र में विशेषज्ञता दिखाएं, विश्वसनीय स्रोतों से लिंक करें और लेखक की साख स्पष्ट रूप से दर्शाएं। फर्स्ट-हैंड अनुभव पर जोर दें।
- 5ताज़ा और वास्तविक समय के प्रासंगिक रहें
अपने कंटेंट को नियमित रूप से अपडेट करें ताकि यह सुनिश्चित हो सके कि यह नवीनतम जानकारी को दर्शाता है और प्रासंगिक बना रहता है। AI नवीनतम जानकारी को अत्यधिक प्राथमिकता देता है।
- 6दृश्यमान और संदर्भ-युक्त उद्धरण तैयार करें
AI मॉडल के लिए अपने कंटेंट को उद्धृत करना आसान बनाने के लिए स्पष्ट रूप से संदर्भित जानकारी और उद्धरणों को शामिल करें। आंतरिक और बाहरी लिंक का रणनीतिक उपयोग करें। संदर्भों को स्पष्ट रूप से लेबल करें।
- 7कंटेंट को 'AI-रेडी' प्रारूप में संरचित करें
अपनी सामग्री को छोटे पैराग्राफ, बुलेट पॉइंट, सूचियों और सारांशों के साथ संरचित करें ताकि AI उसे आसानी से संसाधित और प्रस्तुत कर सके, खासकर AI ओवरव्यू और मल्टीमॉडल आउटपुट के लिए।
आपकी सामग्री को 2026 में किस LLM उद्धरण चरण पर अधिक ध्यान देना चाहिए?
सर्वोत्तम परिणामों के लिए कंटेंट को रिट्रीवल, रैंकिंग और रेंडरिंग तीनों चरणों के लिए ऑप्टिमाइज़ करना चाहिए, लेकिन यदि एक विशेष चरण में कमी है, तो उस पहलू पर रणनीतिक ध्यान केंद्रित करने से समग्र LLM उद्धरण प्रदर्शन में सुधार हो सकता है, विशेष रूप से 2026 के AI-प्रथम परिदृश्य में।
कंटेंट ऑप्टिमाइजेशन के संदर्भ में, यह निर्धारित करना कि LLM उद्धरण के किस चरण पर सबसे अधिक ध्यान देना चाहिए, आपकी विशिष्ट सामग्री, आपके लक्ष्य और आपके प्रतिस्पर्धी परिदृश्य पर निर्भर करता है। हालांकि, 2026 में एक समग्र दृष्टिकोण सबसे प्रभावी है। प्रत्येक चरण सामग्री के जीवनचक्र में एक अलग लेकिन महत्वपूर्ण भूमिका निभाता है, और वे पहले से कहीं अधिक परस्पर निर्भर हैं।
यदि आपकी सामग्री अभी सर्च इंजन या AI रिट्रीवल सिस्टम द्वारा नहीं मिल पा रही है, तो रिट्रीवल पर ध्यान केंद्रित करना आपकी पहली प्राथमिकता होनी चाहिए। इसमें प्रासंगिक सिमेंटिक कीवर्ड ऑप्टिमाइजेशन, उन्नत संरचित डेटा और यह सुनिश्चित करना शामिल है कि आपकी वेबसाइट तकनीकी रूप से सुदृढ़ और वास्तविक समय के डेटा स्रोतों से जुड़ी हुई है। मल्टीमॉडल कंटेंट को भी AI-खोज योग्य बनाना महत्वपूर्ण है।
एक बार जब आपकी सामग्री मिल जाती है, तो उसे रैंकिंग में उच्च स्थान पर लाने के लिए आपको इसकी गुणवत्ता, अधिकार और E-E-A-T पर ध्यान केंद्रित करना होगा। यह लेखक की साख, फर्स्ट-हैंड अनुभव, नवीनतम जानकारी, विश्वसनीय बैकलिंक और तथ्यात्मक सटीकता के माध्यम से प्राप्त किया जाता है। यदि लोग आपकी सामग्री ढूंढ रहे हैं और AI उसे संभावित स्रोत के रूप में पहचान रहा है, लेकिन उसे AI ओवरव्यू या डायरेक्ट आंसर में शामिल नहीं कर रहा है, तो रैंकिंग समस्या हो सकती है।
- रिट्रीवल: सिमेंटिक कीवर्ड अनुसंधान, तकनीकी SEO, उन्नत स्कीमा मार्कअप (मल्टीमॉडल सहित), ज्ञान ग्राफ एकीकरण, वास्तविक समय डेटा स्रोत एकीकरण।
- रैंकिंग: मजबूत E-E-A-T निर्माण (लेखक साख, फर्स्ट-हैंड अनुभव, साइट प्रतिष्ठा), मजबूत लिंक प्रोफाइल, कंटेंट की तथ्यात्मक गुणवत्ता, उपयोगकर्ता अनुभव, नवीनता और पूर्वाग्रह-मुक्त लेखन।
- रेंडरिंग: प्रत्यक्ष उत्तर, संक्षेपण, स्पष्ट और तार्किक संरचना (शीर्षक, बुलेट, सूचियाँ, तालिकाएँ), HTML/CSS/JavaScript संगतता, निष्कर्ष, मल्टीमॉडल सामग्री (चित्र, वीडियो) और इंटरैक्टिव तत्व।
निर्णय मैट्रिक्स: 2026 में आपके कंटेंट के लिए कौन सा चरण सबसे महत्वपूर्ण है?
जबकि रिट्रीवल, रैंकिंग और रेंडरिंग सभी LLM उद्धरण के लिए महत्वपूर्ण हैं, 'रैंकिंग' अक्सर 2026 में सबसे चुनौतीपूर्ण और महत्वपूर्ण माना जाता है, क्योंकि यह सीधे तौर पर LLM द्वारा किसी स्रोत की विश्वसनीयता और E-E-A-T को निर्धारित करता है, लेकिन इष्टतम परिणामों के लिए एक संतुलित, समग्र दृष्टिकोण आवश्…
LLM उद्धरण के तीनों चरणों - रिट्रीवल, रैंकिंग और रेंडरिंग - में से प्रत्येक का अपना महत्व है और वे एक दूसरे पर निर्भर करते हैं। यह तय करना कि कौन सा चरण 'सबसे महत्वपूर्ण' है, इस बात पर निर्भर करता है कि आपकी सामग्री वर्तमान में कहाँ कमजोर पड़ रही है और आप क्या हासिल करना चाहते हैं। हालाँकि, आज के AI-पहने परिदृश्य में, 'रैंकिंग' को अक्सर सबसे चुनौतीपूर्ण और महत्वपूर्ण माना जाता है, क्योंकि यह सीधे तौर पर निर्धारित करता है कि क्या आपकी सामग्री को LLM द्वारा एक विश्वसनीय, अधिकारपूर्ण और तथ्यात्मक रूप से सही स्रोत के रूप में देखा जाएगा। रिट्रीवल आवश्यक है, क्योंकि यदि आपकी सामग्री पहले नहीं मिली है तो वह रैंक नहीं कर सकती; और रेंडरिंग महत्वपूर्ण है क्योंकि यदि AI को जानकारी प्रस्तुत करने में कठिनाई होती है, तो उसका मूल्य कम हो जाता है, भले ही वह उच्च रैंक पर हो।
2026 तक, रैंकिंग की जटिलता बढ़ी है, जिसमें E-E-A-T (विशेष रूप से अनुभव), वास्तविक समय की नवीनता और पूर्वाग्रह-मुक्त सामग्री पर अधिक ध्यान दिया गया है। इसलिए, हालांकि सभी चरण आवश्यक हैं, AI द्वारा एक स्रोत की 'सत्यता' और 'अधिकारिता' का मूल्यांकन करने वाले एल्गोरिदम में रैंकिंग सबसे अधिक नवाचार देख रही है। यह सुनिश्चित करना कि आपकी सामग्री उच्चतम गुणवत्ता और विश्वसनीयता मानकों को पूरा करती है, इस चरण में निवेश का उच्चतम प्रतिफल देगा।
अंतिम विश्लेषण में, तीनों एक दूसरे के पूरक हैं। एक अच्छी तरह से अनुकूलित सामग्री जो रिट्रीवल के लिए इंजीनियर है (ज्ञान ग्राफ, वास्तविक समय डेटा, मल्टीमॉडल), रैंकिंग के लिए विश्वसनीय है (उच्च E-E-A-T), और रेंडरिंग के लिए संरचित है (AI ओवरव्यू-तैयार), AI-जनित उत्तरों में उद्धृत होने और प्रदर्शित होने की सबसे अच्छी संभावना होगी। यह एक त्रि-आयामी दृष्टिकोण है जहां प्रत्येक आयाम उतना ही महत्वपूर्ण है जितना कि दूसरा, लेकिन रैंकिंग में सूक्ष्म अंतर आपकी सफलता को निर्धारित कर सकते हैं।
LLM उद्धरण और AI ओवरव्यू के लिए अपनी सामग्री को प्रभावी ढंग से ऑप्टिमाइज़ कैसे करें (2026 दिशानिर्देश)
- 1अपनी सामग्री को सिमेंटिक रूप से संरचित करें
स्पष्ट शीर्षकों (H1, H2, H3), उपशीर्षकों, बुलेट पॉइंटों और एक सारांश के साथ एक तार्किक प्रवाह का उपयोग करें। यह AI को महत्वपूर्ण जानकारी को आसानी से निकालने और प्रस्तुत करने में मदद करता है। अब AI सिर्फ कीवर्ड नहीं, बल्कि संदर्भ और अवधारणाओं को समझता है।
- 2प्रत्यक्ष, संक्षिप्त और वास्तविक समय के उत्तर प्रदान करें
सीधे उन प्रश्नों का उत्तर दें जिनकी लक्षित दर्शक तलाश कर रहे हैं। सुनिश्चित करें कि ये उत्तर संक्षिप्त, तथ्यात्मक और नवीनतम जानकारी पर आधारित हों। AI वास्तविक समय की जानकारी को प्राथमिकता देता है।
- 3E-E-A-T और विश्वसनीयता स्थापित करें
अपने कंटेंट की विशेषज्ञता, अनुभव, अधिकार और विश्वसनीयता प्रदर्शित करें। इसमें लेखक बायोस, विश्वसनीय स्रोतों के लिंक, उद्योग की मान्यता और केस स्टडी शामिल हैं। Google के 2026 के गुणवत्ता दिशानिर्देश E-E-A-T को पहले से भी अधिक महत्व देते हैं, विशेष रूप से 'अनुभव' पहलू पर। अपनी सामग्री में फर्स्ट-हैंड अनुभव और विशेषज्ञता को उजागर करें।
- 4उन्नत स्कीमा मार्कअप का उपयोग करें
अपनी सामग्री (जैसे FAQPage, HowTo, Article, QAPage, Person, Review, WebPage) के प्रकार के आधार पर संरचित डेटा मार्कअप लागू करें। यह AI को आपके कंटेंट को अधिक सटीकता से समझने, वर्गीकृत करने और उद्धृत करने में मदद करता है। JSON-LD को प्राथमिकता दें।
- 5बुद्धिमानी से लिंक करें और संदर्भ प्रदान करें
अन्य संबंधित, आधिकारिक स्रोतों से लिंक करें (बाहरी) और अपनी स्वयं की वेबसाइट के भीतर संबंधित कंटेंट से लिंक करें (आंतरिक)। AI मॉडल उन स्रोतों को पसंद करते हैं जो अपने दावों का समर्थन करते हैं, और वास्तविक समय के डेटाबेस से जुड़ना महत्वपूर्ण है। संदर्भों को स्पष्ट रूप से दर्शाएं।
- 6नियमित रूप से अपडेट करें और संशोधित करें
अपनी जानकारी को ताज़ा और सटीक रखने के लिए अपने कंटेंट को नियमित रूप से समीक्षा और अपडेट करें। AI नवीनतम और सबसे विश्वसनीय जानकारी को अत्यधिक प्राथमिकता देता है। पुराने या बासी कंटेंट को शायद ही कभी उद्धृत किया जाता है, खासकर यदि यह तेजी से विकसित हो रहे विषयों से संबंधित हो।
- 7मोबाइल-फर्स्ट और एक्सेसिबल डिज़ाइन पर ध्यान दें
सुनिश्चित करें कि आपकी वेबसाइट मोबाइल उपकरणों पर तेजी से लोड हो और सुलभ हो। AI मॉडल उपयोगकर्ता अनुभव को रैंकिंग संकेतों के रूप में उपयोग करते हैं, और धीमी या गैर-पहुँच योग्य साइटें AI उद्धरण के लिए कम प्राथमिकता वाली होती हैं। Core Web Vitals का अनुपालन महत्वपूर्ण है।
Key terms
- लार्ज लैंग्वेज मॉडल्स (LLMs)
- बड़े पैमाने पर टेक्स्ट डेटा पर प्रशिक्षित AI मॉडल जो मानव-जैसे टेक्स्ट को समझ सकते हैं, उत्पन्न कर सकते हैं और प्रश्नों का उत्तर दे सकते हैं। वे चैटबॉट्स, कंटेंट जनरेशन और सारांश जैसे अनुप्रयोगों की नींव हैं।
- रिट्रीवल ऑगमेंटेड जनरेशन (RAG)
- एक AI वास्तुकला जो एक LLM को प्रश्नों का उत्तर देने के लिए बाहरी, वास्तविक समय डेटा स्रोतों से जानकारी पुनर्प्राप्त करने की अनुमति देती है, जिससे मॉडल की सटीकता और प्रासंगिकता में सुधार होता है और हैलुसिनेशन कम होता है।
- खोज इंजन ऑप्टिमाइजेशन (SEO)
- पारंपरिक वेब सर्च इंजनों (जैसे Google, Bing) के लिए वेबसाइटों या कंटेंट को ऑप्टिमाइज़ करने की प्रक्रिया ताकि खोज परिणामों में उनकी दृश्यता में सुधार हो। इसमें कीवर्ड, बैकलिंक्स और तकनीकी SEO शामिल हैं।
- उत्तर इंजन ऑप्टिमाइजेशन (AEO)
- AI-संचालित सर्च इंजन (जैसे Google AI ओवरव्यू, Microsoft Copilot) के लिए कंटेंट को ऑप्टिमाइज़ करने की प्रक्रिया ताकि उसे प्रत्यक्ष उत्तरों और सारांश में शामिल किया जा सके, विशेष रूप से 2026 के AI-प्रथम खोज परिदृश्य के लिए।
- जनरेटिव इंजन ऑप्टिमाइजेशन (GEO)
- ChatGPT, Perplexity AI, Claude, Gemini जैसे जनरेटिव AI मॉडल्स द्वारा सटीक और विश्वसनीय उद्धरणों के रूप में Content को पहचाने और उपयोग किए जाने के लिए ऑप्टिमाइज़ करने की रणनीति।
- उद्धरण
- AI-जनित उत्तर में जानकारी का मूल स्रोत या संदर्भ, जो विश्वसनीयता, पारदर्शिता और सत्यता प्रदान करता है, जिससे उपयोगकर्ता स्रोत की पुष्टि कर सकें।
- हैलुसिनेशन
- जब एक LLM गलत, मनगढ़ंत या असत्य जानकारी उत्पन्न करता है, अक्सर संदर्भ की कमी या प्रशिक्षण डेटा में खामियों के कारण।
- E-E-A-T
- विशेषज्ञता, अनुभव, अधिकार और विश्वसनीयता (Expertise, Experience, Authoritativeness, Trustworthiness) के सिद्धांत, जो Google की खोज गुणवत्ता मूल्यांकन दिशानिर्देशों का एक महत्वपूर्ण हिस्सा हैं और AI उद्धरण के लिए भी महत्वपूर्ण हैं।
- मल्टीमॉडल AI
- AI सिस्टम जो टेक्स्ट, इमेज, ऑडियो और वीडियो जैसे विभिन्न प्रकार के डेटा को एक साथ संसाधित और उत्पन्न कर सकते हैं, जिससे अधिक व्यापक और इंटरैक्टिव आउटपुट संभव होते हैं।
FAQ
Concepts & entities in this article
Sources
- [1]Retrieval Augmented Generation (RAG): A New Paradigm for LLMs — arXiv
- [2]Google Search Central Blog: The Latest on Search & AI — Google
- [3]OpenAI Official Blog: Advancing AI Safety — OpenAI
- [4]Anthropic Research Papers — Anthropic
- [5]Google's E-E-A-T: What It Is & Why It's Important — Search Engine Journal
- [6]What is AI Search Optimization (AEO)? — Semrush
Related articles
Schema.org बनाम विकीडेटा: AI उद्धरणों को कौन अधिक बढ़ावा देता है?
Schema.org और विकीडेटा का तुलनात्मक विश्लेषण: जानें कि 2026 में संरचित डेटा और सिमेंटिक ज्ञान ग्राफ AI उद्धरणों को कैसे संचालित करते हैं।
एआई सर्च इंजन कैसे तय करते हैं कि किन स्रोतों का हवाला देना है?
जानिए 2026 में एआई सर्च इंजन किन स्रोतों का हवाला देते हैं, उनके चयन एल्गोरिदम, उद्धरण मानदंड और आपकी सामग्री को एआई द्वारा उद्धृत कराने की सर्वोत्तम रणनीतियाँ।
AI Search Optimization Tools: Profound vs Peec AI तुलना
AI search optimization tools की विस्तृत तुलना: Profound vs Peec AI। जानें फीचर्स, मॉडल कवरेज, ट्रैकिंग सटीकता और अपनी GEO रणनीति के लिए सही टूल।