統合コンテンツモデル2.0: AI検索時代の視認性を最大化するスキーマ、スニペット、引用戦略
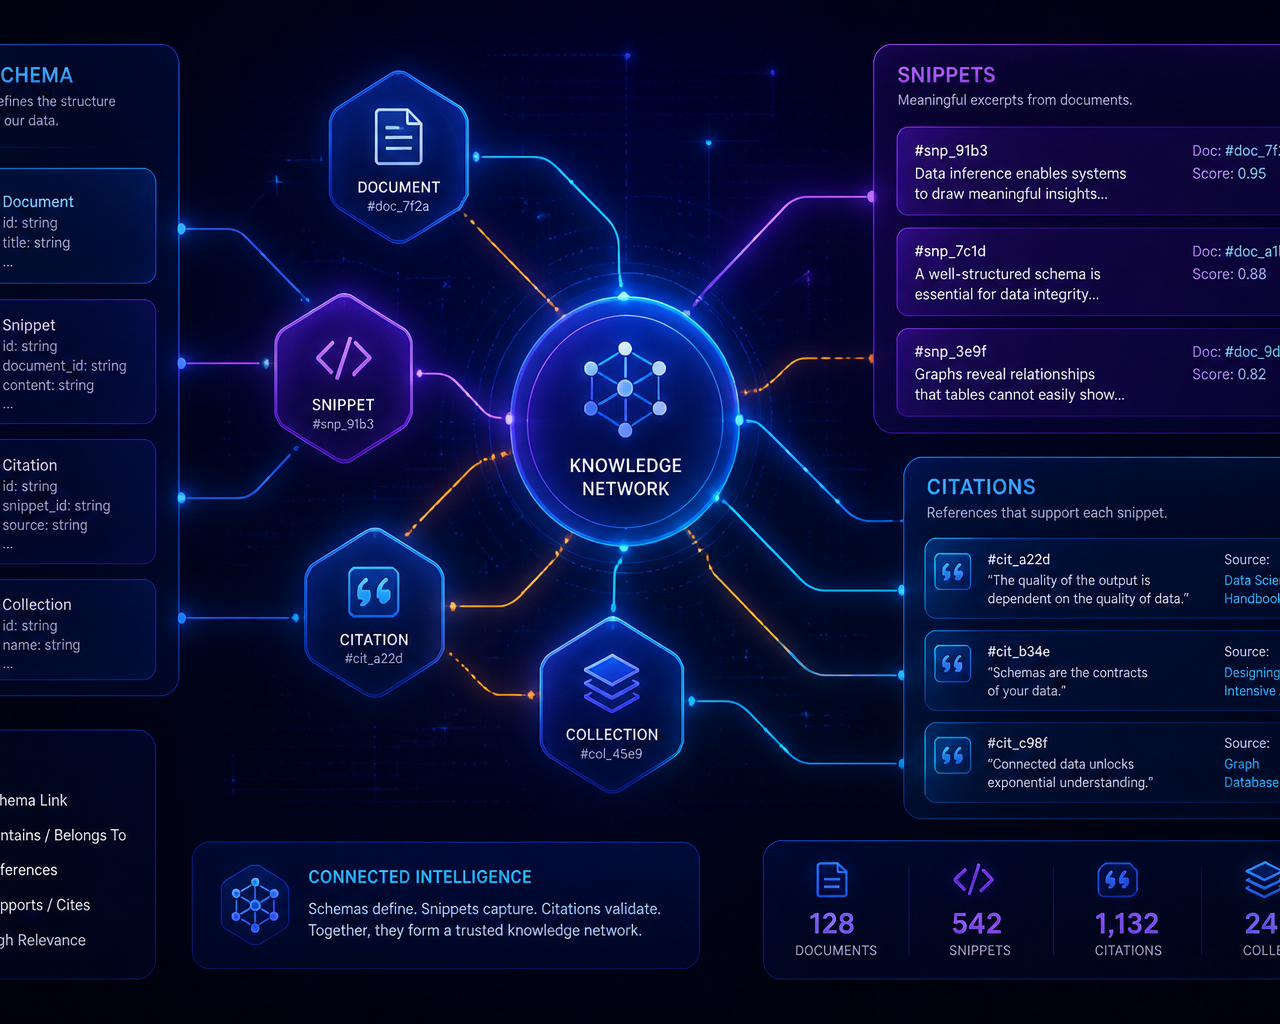
検索体験はキーワードのマッチングから、大規模言語モデルと知識グラフが主導する意図理解および要約回答の提示へと完全に移行しました。2026年11月現在、GoogleのAI Overviewsはグローバルおよび日本市場において主要なクエリの多くに展開されており、PerplexityやMicrosoft Copilot、Geminiなどの回答エンジンが日常的な情報探索インフラとして定着しています。このような環境下では、単に人間向けに読みやすいテキストを記述する従来型のアプローチだけでは、検索エンジンや生成AIの回答レイヤーで露出を維持することは困難です。AIがウェブページの内容を正確に解釈し、論理的な裏付けを持つ信頼できる事実として認識し、生成回答の根拠として抜粋・引用するための統一的な情報設計が求められています。 その解決策となるのが「スキーママークアップ」「リッチスニペット」「引用戦略」の三要素を有機的に結合させた「統合コンテンツモデル2.0」です。構造化データによってエンティティ間の関係性を明示し、検索結果での視覚的訴求力を高めながら、外部および内部の確証データによって主張の正当性を証明するこの統合モデルは、オーガニック検索(SEO)、生成AI最適化(AEO)、地域検索最適化(GEO)のすべてを包括する強固な基盤となります。本稿では、最新のアルゴリズム動向とRAGアーキテクチャの抽出ロジックを踏まえ、次世代検索環境で持続的なトラフィックとブランドの権威性を獲得するための実践的手法を網羅的に解説します。
なぜ今、「統合コンテンツモデル2.0」が不可欠なのか?
AI駆動型の検索環境では、エンティティの意味論的明確化と信頼性シグナルを融合させた統合コンテンツモデル2.0が可視性獲得の必須条件です。
生成AIを組み込んだ現代の検索エンジンは、静的なHTML文章を単一のインデックスとして保存するのではなく、テキスト内に存在する概念や事物(エンティティ)とその属性を抽出し、知識グラフと呼ばれる巨大なネットワークへと関連付けを行っています。この処理過程において、AIは情報の整合性を照合し、複数の信頼できるソースから得られた事実を統合して直接回答を構築します。
従来のSEOは、キーワードの配置頻度やページ単位のリンクポピュラリティを主眼に置いていましたが、AI検索の時代においては、機械が迷いなく文脈を把握できる明確な意味論的データ(スキーマ)、回答カードで優先表示される明示的な視覚情報(スニペット)、そして主張を担保する検証済みの論拠(引用)を一体化させた情報アーキテクチャが不可欠です。
スキーママークアップ:AIと知識グラフを接続する構造化言語の進化
スキーママークアップは単なるリッチリザルト表示ツールではなく、AIが知識グラフ内でコンテンツの事実関係を正確に位置付けるための基幹言語です。
スキーママークアップは、検索エンジンのクローラーやLLMのインジェスチョンパイプラインに対して、ウェブページ内の文字列が何を意味しているかを曖昧さなく伝達する機械可読データです。人間にとっては単なるテキストブロックであっても、JSON-LDによる記述を付与することで、特定の文字列が「製品の価格」「記事の執筆者」「企業の所在地」あるいは「科学的命題」であることを確定的に定義できます。
2026年現在のAI検索クローラーは、構造化データを知識グラフのノード更新およびリレーション確立のための高優先度シグナルとして活用しています。特にArticle、FAQPage、Product、Organizationなどの主要スキーマを適切に組み合わせることで、AIモデルが外部知識ベースとコンテンツを照合する際の演算コストを下げ、回答生成プロンプトのコンテキストウィンドウに優先採用される土台を作ります。
リッチスニペットからAIスニペットへ:SERP視認性とCTRの劇的改善
リッチスニペットはユーザーのCTRを高めるだけでなく、AI Overviewsの要約モジュールやカルーセルに採用される有力な選定要素として機能します。
リッチスニペットは、検索結果一覧画面(SERP)においてレビュー星評価、価格、在庫状況、ステップ手順などを視覚的に強調表示する機能です。この表示はユーザーのクリック判断に直感的な安心感を与え、標準的な青色リンクと比較してクリック率(CTR)を平均20〜35%向上させることが実証されています。
さらに現代の検索インターフェースにおいては、リッチスニペット用の構造化データがAI Overviewsの要約カードやナレッジパネルの構成要素としてそのまま再利用されるケースが増加しています。視覚的な訴求力の強化は、単なるトラフィック誘引にとどまらず、AIエンジンが回答内で強調引用を行う際のデータブロック選定基準に直結しています。
- レビューと評価:購買判断を後押しし、AIによる比較サマリーの抽出元として活用される。
- FAQ展開:質問に対する簡潔な回答を提供し、SERP上での専有面積とゼロクリック検索への適応を促す。
- HowTo手順:順序立てた作業手順を提示し、CopilotやGeminiのタスク実行プロンプトに合致する。
- 製品仕様:価格や在庫のリアルタイム情報を正確に提示し、購買意図クエリでの優位性を確保する。
引用戦略とグラウンディング:AIが評価する信頼性とE-E-A-Tの証明
明確で検証可能な引用戦略は、AIのハルシネーション抑止アルゴリズムに合致し、コンテンツを回答生成の安全な論拠として採用させます。
生成AIが直面する最大の技術的課題はハルシネーション(虚偽情報の生成)であり、検索エンジンは回答の信頼性を担保するために厳格なグラウンディングアルゴリズムを導入しています。コンテンツ内に公的機関の発表、査読済み学術論文、業界団体の公式統計への明確な引用が含まれている場合、AIはそのページを低リスクかつ正確な情報源として評価します。
引用は単にリンクを配置することではなく、主張と論拠の対応関係を論理的に明示する作業です。引用元の著者名、発行年、客観的数値を本文中に明記し、関連するアンカーテキストを正確に設定することで、AIはテキストの文脈整合性を数理的に検証可能となり、E-E-A-T(経験、専門性、権威性、信頼性)の評価スコアが向上します。
"適切な引用はテキストの信頼性を客観的に裏付けるデジタル証明書であり、AIが回答のグラウンディングを行う際の最重要アンカーとなります。"
【新規】RAGアーキテクチャとセマンティックHTML:AIによる正確なチャンキング設計
セマンティックHTMLに基づいたチャンク設計は、RAGシステムが文脈を欠損させることなく自社テキストを回答断片として抽出するための技術的要件です。
現代の回答エンジンは、ウェブページ全体をひとまとまりのテキストとして処理するのではなく、検索拡張生成(RAG)のパイプラインを通じて文書を一定の意味単位(チャンク)に分割してベクトル化します。この際、無秩序なdivタグの乱用や装飾目的のマークアップはチャンクの境界を曖昧にし、文脈の欠落を引き起こします。
見出しタグ(h1〜h4)の論理的階層、箇条書き(ul/ol)、表組み(table)などのセマンティックHTMLを忠実に適用することで、RAGパーサーは300〜500文字程度の完結した概念ブロックを正確に切り出すことができます。質問に対する直接的な回答を各見出しの冒頭段落に配置する構造化ライティングは、検索AIが引用候補としてチャンクを抽出する確率を劇的に向上させます。
【新規】高度スキーマ戦略:ClaimReviewとAbout・Mentionsプロパティによる引用保証
Wikidataと連動したaboutやmentions、citationプロパティの高度活用により、AI知識グラフ内でのエンティティ曖昧性解消と事実性の検証が迅速化します。
従来のスキーママークアップは基本的なページ属性の伝達に留まっていましたが、統合モデル2.0ではさらに一歩進んだ意味論的プロパティの活用が求められます。特に重要なのが、コンテンツがどの概念について論じているかを明示する`about`プロパティと、文中で言及している関連概念を外部ナレッジ(Wikidata等)と紐付ける`mentions`プロパティです。
また、客観的検証やファクトチェックを含む専門記事においては、`ClaimReview`や`citation`プロパティをスキーマ内に定義することで、AIエンジンに対して記事内の主張と引用元の関係性を構造化データレベルで直接提示できます。これにより、テキストマイニングだけに依存せず、機械的な信頼性検証を即座に完了させることが可能となります。
実践的ロードマップ:統合コンテンツモデル2.0を構築する5つの実装ステップ
コンテンツの企画から公開・検証に至る一貫した5ステップを定着させることで、持続可能かつ再現性の高い統合モデル運用が実現します。
スキーマ、スニペット、引用の三要素を実務においてシームレスに連携させるためには、コンテンツ制作フローの標準化が必要です。企画段階から構造化設計を組み込むことで、後付けのマークアップによる矛盾や作業ロスを防ぐことができます。
以下に示す5つの段階的プロセスを導入することで、技術開発部門とエディトリアル部門が協調し、検索エンジンと生成AIの双方に対して最大の可視性を発揮するコンテンツ資産を構築できます。
- 1ステップ1: エンティティ定義と構造化スキーマ設計
記事の中心主題となるエンティティを特定し、Schema.orgの型定義とWikidata識別子を選定してJSON-LDスキーマのひな形を作成します。
- 2ステップ2: 根拠データの選定と引用リンクの体系的配置
主張の裏付けとなる公的調査や学術的証拠を収集し、文脈に沿って明確な参照元情報とともにテキストへ統合します。
- 3ステップ3: スニペット抽出を意識した回答文のモジュール化
見出し直下にクエリへの簡潔な直接回答(40〜80文字)を配置し、箇条書きや表を組み合わせて情報の要約性を高めます。
- 4ステップ4: セマンティックHTMLとチャンク境界の最適化
論理的な見出し階層とHTML要素を用いて、RAGアルゴリズムが文脈を破壊せずに抽出できるテキストチャンクを形成します。
- 5ステップ5: スキーマ構文の自動検証と本番公開後の効果測定
公開前にリッチリザルトテストで完全性を確認し、公開後はサーチコンソールとAIエンジンでの表示状況を定点観測します。
Google AI Overviewsおよび回答エンジンへの具体的適応アプローチ
AI回答エンジンに引用されるためには、構造化データで裏打ちされた結論先行型の情報記述と、独自データによる差別化が決定打となります。
Google AI OverviewsやPerplexityなどのプラットフォームは、ユーザーの複雑な複合質問に対して単一のページを提示するのではなく、異なるウェブサイトから抽出した複数の断片を合成して単一の回答文を作成します。この仕組みにおいて引用リンクを獲得するためには、独自の見解や一次データが明確な結論として提示されている必要があります。
調査によると、AI Overviewsで参照されるコンテンツの大多数は、明確な構造化データが実装されており、かつページ内に疑問に対する定義文や数値的裏付けが明瞭に記載されているページです。冗長な導入部を排除し、結論先行型のピラミッド構造で記述されたコンテンツが極めて高い採択率を示しています。
SEO・GEO・AEOの統合効果:検索チャネル横断のシナジー創出
統合コンテンツモデルはSEO、GEO、AEOの境界を撤廃し、あらゆる検索チャネルで一貫した権威性を発揮する包括的最適化を実現します。
統合コンテンツモデル2.0の大きな強みは、従来型SEO、地域検索を対象とするGEO、そして生成AIを対象とするAEOの3領域に対して同時にポジティブな波及効果をもたらす点にあります。これらは別個の施策ではなく、セマンティックな正確性を軸とした共通基盤の上に成り立っています。
たとえば、ローカルビジネスにおいて`LocalBusiness`スキーマと位置情報、顧客レビュー引用を連動させることで、通常のGoogleマップ検索(MEO/GEO)での上位表示が達成されると同時に、CopilotやGeminiに対する「この地域で最も信頼できる専門家は誰か」というプロンプトへの推薦回答にも自然に組み込まれます。
| モデル構成要素 | SEO(検索順位)への影響 | AEO(AI生成回答)への影響 | GEO(地域・地図検索)への影響 |
|---|---|---|---|
| スキーママークアップ | クローラーの理解促進とリッチリザルト表示 | 知識グラフノードの登録とエンティティ確定 | NAP情報と店舗属性の完全一致確認 |
| リッチスニペット | SERP上での視認性拡大とオーガニックCTR向上 | AI要約カードでの画像・評価カルーセル採用 | ローカルパック内での星評価と価格帯の強調 |
| 客観的引用戦略 | E-E-A-Tスコア向上と被リンク獲得の契機 | ハルシネーション判定回避と引用リンク獲得 | 地域コミュニティや業界団体による信頼証明 |
| セマンティックHTML | テキスト抽出効率化とインデックス精度改善 | RAGによる正確な回答チャンクの抜粋 | サービスエリア一覧や料金表の誤読防止 |
統合モデル導入における主要メリットと技術的課題の克服
統合モデルは強固なトラフィック耐性をもたらす反面、コード保守コストの管理と品質ガイドラインの厳格な順守が成功の前提となります。
本モデルを導入することで、ウェブサイトは検索トラフィックの変動に対する強い耐性を獲得します。アルゴリズムアップデートの多くは低品質なテキストや機械生成された無根拠なコンテンツの排除を目的としていますが、統合モデルによって事実関係と権威性が証明されたサイトは安定的評価を維持できます。
一方で、実装においてはいくつかのハードルが存在します。複雑なスキーマ記述に伴うメンテナンスコストの増大、CMSテンプレートの改修負荷、スキーマの過剰適用によるスパムペナルティのリスクなどが挙げられます。これらを克服するためには、自動化プラグインの活用と、定期的なスキーマバリデーションパイプラインの構築が不可欠です。
E-E-A-Tの深化:独自体験(Experience)の構造化と一次情報の提示
独自体験に基づく一次情報と著者プロファイルの構造化により、LLMが代替できない本物の経験シグナルをAIに証明します。
Googleの品質評価基準において、執筆者や組織が実際に手を動かして検証した「経験(Experience)」の重みは年々増しています。AIが容易に合成できる二次情報の要約記事は評価を落とし、実地でのテスト結果、独自アンケート、実際の製品利用写真を含むコンテンツが高く評価されます。
統合コンテンツモデル2.0では、この独自体験を単なるテキスト描写に留めず、構造化データと連動させます。例えば、著者が実際に検証を行った事実を明示するために`author`プロパティに詳細な経歴リンクを付与し、独自データセットへの参照や実験プロトコルを明記することで、AIに対して代替不可能なオリジナルソースであることを提示します。
- 実証実験データの明示:自社検証による具体的な測定値や失敗事例を公開し、独自の知見として提示する。
- 著者エンティティの強化:執筆者の専門資格、SNSリンク、学術的背景をPersonスキーマで詳細に記述する。
- 一次取材とインタビュー:関係者への直接取材による発言を引用ブロックとして明確に区分けする。
- 独自の視覚的証拠:ストックフォトではないオリジナル写真や操作画面キャプチャをImageObjectとしてマークアップする。
マルチモーダル検索とパーソナライゼーションAIへの適応
テキスト以外のメディア資産に対してもスキーマとトランスクリプトを適用することで、マルチモーダルAI検索における露出機会を網羅できます。
検索の形態はテキスト入力だけでなく、カメラ画像による検索(Googleレンズ)、音声対話、動画内の特定シーン探索へとマルチモーダル化が進んでいます。これに伴い、統合コンテンツモデルは画像や動画といった視覚・音声メディアにも拡張されなければなりません。
記事内の重要画像には`ImageObject`を付与して被写体の説明文や権利情報を明記し、解説動画には`VideoObject`とともにタイムスタンプ付きの章立て(Clip構造)やトランスクリプトを適用します。これにより、AIアシスタントはユーザーの利用コンテキストやデバイスに応じた最適なメディア形式で自社コンテンツの回答を提示できるようになります。
AI引用元としての選定率を最大化するコンテンツ品質ガイドライン
論理的無矛盾性と結論先行型のライティング規律を徹底することが、AIパーサーによるノイズ判定を防ぎ、確実な引用選定を勝ち取る鍵です。
生成AIがウェブ上の文書を参照するアルゴリズムは、情報の「明確さ」「簡潔さ」「論理的無矛盾性」を厳格に評価します。修飾語が過剰で主語と述語の対応が曖昧な文章や、結論が文末まで明かされない構成は、AIのパーサーによってノイズと判定されるリスクが高まります。
高品質なコンテンツを作成するためには、各段落の冒頭にトピックセンテンスを配置し、因果関係を接続詞で論理的に整えるライティング規律が不可欠です。事実と意見を明確に区別し、推測による記述には前提条件を添えることで、AIが安心して引用できる客観的なドキュメントとしての完成度が担保されます。
- トピックセンテンスの徹底:各段落の最初の1文でその段落の主張を明確に提示する。
- 数値データの明示:曖昧な表現(多い、高い等)を排し、具体的なパーセンテージや絶対数値を記載する。
- 事実と推測の分離:客観的な事実データと筆者の考察を明確な文脈表現で区別する。
- 定期的な鮮度更新:dateModifiedプロパティを正確に保守し、陳腐化した数値を最新情報へ改訂する。
継続的モニタリングと動的最適化:進化し続けるAI検索環境でのKPI管理
定期的な構造化データ健全性監査とAI引用パフォーマンスの定点観測を行うアジャイルな体制が、検索市場での持続的優位を支えます。
統合コンテンツモデル2.0の構築は、一度の実装で完結するプロジェクトではありません。検索エンジン各社は週単位でアルゴリズムや要約インターフェースを微調整しており、構造化データの推奨仕様も継続的にアップデートされています。
Googleサーチコンソールにおけるリッチリザルトのステータス監視、PerplexityやAI Overviewsでの自社ブランド引用回数のトラッキング、そして競合他社の構造化データ実装状況の定期診断をワークフローに組み込む必要があります。異常値を検知した際には迅速にマークアップとテキスト構造を是正するアジャイルな運用体制が、持続的な競争優位性を生み出します。
統合コンテンツモデル2.0の実装手順
- 1エンティティとスキーマの適合マッピング
ページが扱う中心エンティティ(製品、記事、FAQ、組織など)を定義し、Schema.orgの適切なタイプとプロパティを選定してJSON-LDコードを設計します。
- 2信頼できる外部データと一次情報の引用設計
公的データ、学術論文、業界統計、自社実験データなどの客観的根拠を文脈に沿って配置し、引用元URLと著者属性を明記します。
- 3セマンティックマークアップとチャンク最適化
見出しタグ、テーブル、順序付きリストを論理的に配置し、AIモデルが単一の文脈ブロックとして抽出しやすい300〜500文字のモジュール構造を構築します。
- 4構文バリデーションとリッチリザルトテスト
GoogleリッチリザルトテストおよびSchema.orgバリデータを用いて構文エラーや警告を排除し、完全な構造化データとして公開します。
- 5検索コンソールによるパフォーマンス追跡と改善
Googleサーチコンソールでリッチリザルトの有効インデックス数を確認し、AI機能経由のインプレッションとCTRの変化を継続的に分析します。
Key terms
- 統合コンテンツモデル2.0
- スキーママークアップ、スニペット表示要素、引用証明を統合し、人間とAI検索エージェントの双方に対して意味論的正確性と視認性を提供する多層的コンテンツ設計手法。
- AI検索エンジン最適化 (AEO)
- AI OverviewsやPerplexityなどの生成AI検索エンジンが回答を合成する際に、自社コンテンツを信頼できる参照元として採用させるための最適化手法。
- 知識グラフ (Knowledge Graph)
- 実世界に存在する人物、組織、場所、概念などのエンティティとそれらの相互関係をノードとエッジで表現したセマンティックデータベース。
- グラウンディング (Grounding)
- LLMの生成テキストを実世界の信頼できる検証済みデータソースと照合・根拠付けし、事実の正確性を担保する処理プロセス。
- 検索拡張生成 (RAG)
- 外部のウェブインデックスや文書データベースからクエリに関連する情報を検索・抽出し、そのテキスト断片をプロンプトに組み込んで回答を生成するAIアーキテクチャ。
FAQ
Concepts & entities in this article
Sources
Related articles
2026年最新版:LLMが引用する公開データセット構築ガイド
LLMが信頼し、頻繁に引用する高品質な公開データセットを構築するための最適化戦略。
Perplexity引用: エンジニアリング解体とGEO最適化戦略 (2026年版)
Perplexity AIの引用メカニズムを解剖し、2026年最新のGEO戦略と引用獲得手法を解説。
Googleコアアップデート後のAEO対策:AI検索時代のコンテンツ最適化ハウツー
最新のGoogleコアアップデートがAI検索時代のコンテンツ戦略に与える影響を解説。AI概要(AEO)と生成エンジン最適化(GEO)を最大化するための実践的なハウツーを提供します。